Van persoonlijk gebruik naar AI in je bedrijf, deel 1: de AI-ruggengraat
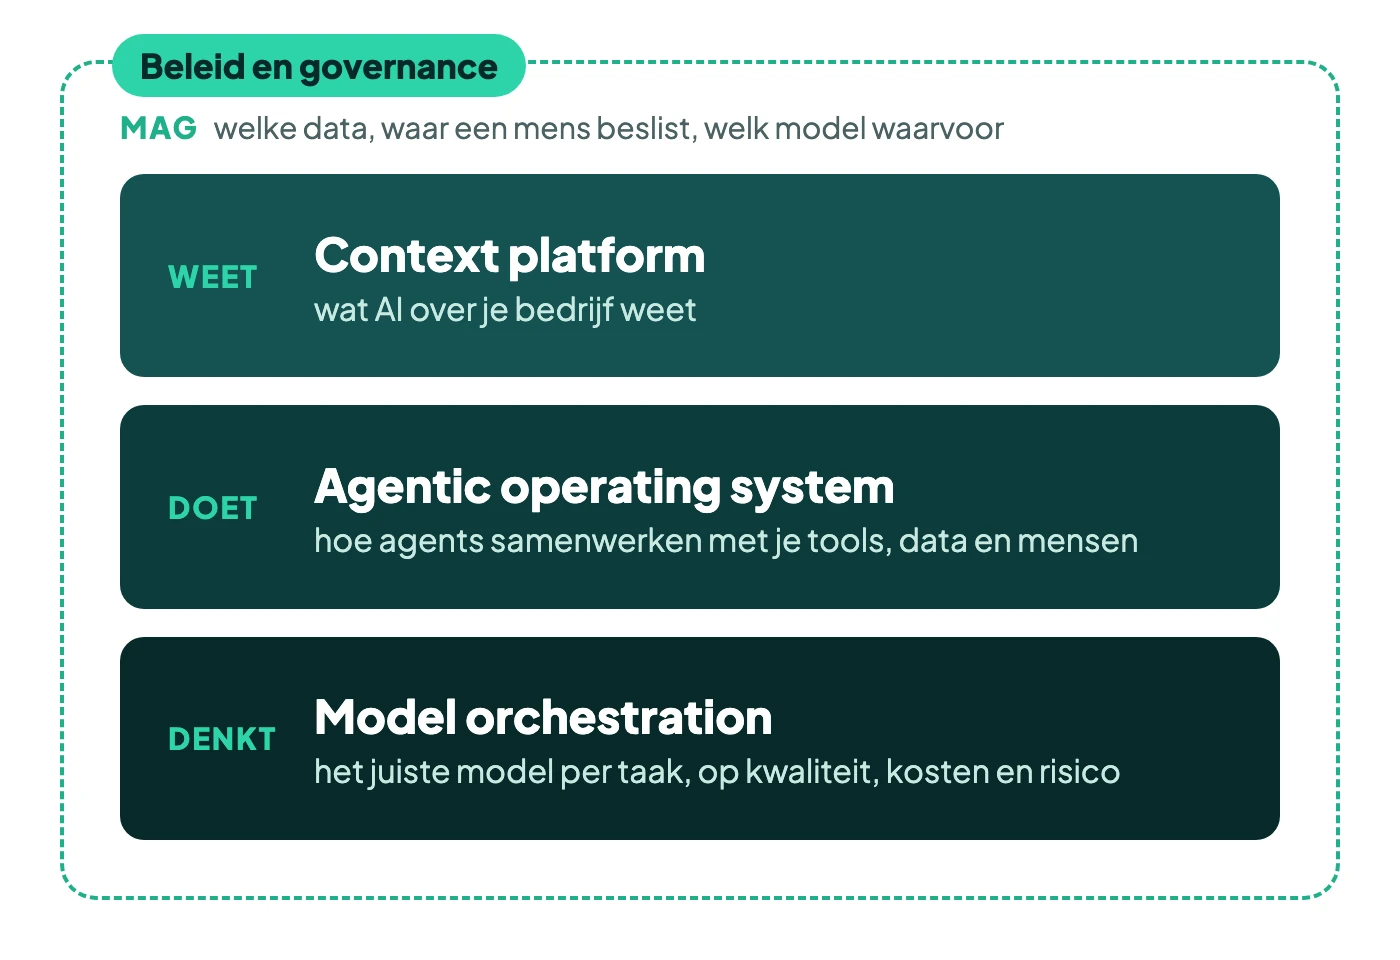
Losse AI-tools worden samen geen AI-organisatie. Drie lagen bepalen wat AI in je bedrijf weet, wat het doet en waarmee het denkt: een context platform, een agentic operating system en model orchestration. En beleid houdt ze bij elkaar.
Minder dan 10% van de agentic AI-implementaties levert een sterk rendement op. Dat schrijft Gartner in de nieuwste Emerging Tech Impact Radar voor generatieve AI. Hun verklaring is opvallend: de technologie is niet het probleem.
Het probleem is dat bedrijven AI in losse stukjes aanschaffen. Een chatbot hier, een agent daar, nog een abonnement op een ander model. Elk met een eigen koppeling naar je data. Elk met eigen afspraken, of geen.
In de serie In 5 stappen AI beter gebruiken ging het over AI voor jezelf: je eigen context, je eigen skills, je eigen routines. Dat werkt. Maar zodra twintig collega’s het ieder op hun eigen manier doen, heb je twintig losse systemen. In deze serie kijken we hoe je AI laat landen in het hele bedrijf.
Wat ontbreekt is een ruggengraat. Je kunt het ook een AI-platform noemen, maar dat woord suggereert één product dat je koopt en installeert. Dat is het niet. Het zijn een paar lagen die samen bepalen wat AI in je bedrijf weet, wat het doet en waarmee het denkt. En beleid bepaalt wat mag.
Context platform: wat AI over je bedrijf weet
Een context platform ordent de kennis over je bedrijf zo dat een agent er iets mee kan. Niet alleen documenten, maar ook de betekenis erachter. Begrippen, relaties, regels, beleid. En als de agent antwoord geeft, verwijst hij naar de bron.
Weet je AI wat bij jullie “een actieve klant” is? Welke prijslijst geldt? Dat zakelijke klanten een andere retourtermijn hebben? Als dat alleen in hoofden zit, gaat elke agent gokken.
Een goede contextlaag brengt implementaties ook van maanden terug naar weken, omdat je minder hoeft te compenseren met slimme prompts. Ik schreef eerder over context als fundament: impliciete kennis expliciet maken. Dat is het begin van deze laag. Daar hoef je geen dure software voor aan te schaffen. Begin met een gedeelde map in SharePoint of Google Drive, met per onderwerp één actueel document. Een begrippenlijst waarin staat wat jullie bedoelen met “actieve klant”. De prijslijst die nu geldt. Het retourbeleid, inclusief de uitzonderingen. Elk document heeft een eigenaar en oude versies gaan naar een archief. Koppel die map aan je AI-tool en je hebt een eerste contextlaag.
En waar groei je naartoe? Naar een situatie waarin je documenten en je systemen, zoals CRM en boekhouding, verbonden zijn via één model van begrippen en hoe ze samenhangen. Een verkoper vraagt of hij een klant 15% korting mag geven. De agent ziet in het CRM dat het een actieve klant is, vindt het kortingsbeleid dat daarbij hoort, weet wie boven die grens moet tekenen en noemt bij elk deel van zijn antwoord de bron. Hij laat alleen zien wat die verkoper mag zien. En past iemand het kortingsbeleid aan, dan geeft de agent vanaf dat moment het nieuwe antwoord.
Agentic operating system: agents voor het hele bedrijf
Zodra AI niet alleen antwoord geeft maar ook dingen doet, heb je een tweede laag nodig. Het agentic operating system coördineert agents, verbindt ze met je data en applicaties, en houdt mensen in controle over de uitkomst.
In deel 2 van de vorige serie koppelde je je eigen tools aan je AI. Daarmee heb je al een agent: hij leest je mail, zoekt iets op in je bestanden en zet een concept klaar. Voor jezelf werkt dat prima. Maar als twintig collega’s dat elk op hun eigen manier doen, weet niemand meer welke agent waar bij kan en wat hij doet.
Het agentic operating system regelt dat voor het hele bedrijf. Vergelijk het met het besturingssysteem van je laptop: apps doen het werk, maar het besturingssysteem bepaalt wie er is ingelogd en bij welke bestanden een app kan. Zo leg je koppelingen en rechten één keer centraal vast, in plaats van per agent en per medewerker.
In de praktijk is het de plek waar je agents inricht en volgt. Je legt per agent vast namens wie hij werkt en bij welke data hij kan. Dus niet automatisch bij de salarisgegevens, alleen omdat de medewerker die hem start dat wel mag. Elke actie wordt vastgelegd, zodat je kunt nalezen wat een agent deed. Doet een agent iets wat niet klopt, dan trek je op die ene plek zijn toegang in en ligt hij overal tegelijk stil.
Bij alles wat je niet kunt terugdraaien, vraagt de agent eerst akkoord. Een agent mag een offerte opstellen, maar het versturen keurt een mens goed. Het beleid bepaalt de regels, het agentic operating system dwingt ze af.
Model orchestration: een team van modellen
De derde laag gaat over de modellen zelf. Als je zelf met AI chat, kies je per taak het juiste model. Maar agents draaien de hele dag door, zonder dat er iemand naast zit die kiest. Model orchestration legt die keuze vast en stuurt elke taak automatisch naar het model dat erbij past.
Dat begint bij kwaliteit en kosten. Een vraag die diep nadenken vraagt gaat naar een zwaar redeneermodel. Een routineklus kan naar een kleiner, sneller model. Dat scheelt flink: modellen onder de 10 miljard parameters zijn meer dan 1000 keer kostenefficiënter om te draaien dan een frontier model.
Daarna komt risico. Een klantdossier met persoonsgegevens wil je misschien niet naar een Amerikaanse cloud sturen, maar naar een model in de EU of op eigen hardware. Model orchestration is dus ook een privacykeuze. En kleinere modellen die je zelf draait kunnen inmiddels meer dan je denkt.
Soms is één model niet genoeg. Dan knip je een taak op en laat je elk model doen waar het goed in is: een klein model sorteert binnenkomende documenten, een zwaar model beoordeelt de lastige gevallen.
En omdat je niet aan één aanbieder vastzit, wissel je van model als er een betere of goedkopere komt, of als er een uitvalt. Ondertussen zie je wat het per afdeling kost, en stel je een budget in voordat de rekening je verrast.
Beleid houdt het bij elkaar
Elke laag kun je technisch inrichten, maar de keuzes erachter maakt techniek niet voor je. Welke klantgegevens mogen in het context platform, en dan volledig of geanonimiseerd? Bij welke acties moet een agent wachten op een mens: betalingen, mails naar klanten, alles wat over personeel gaat? En mag vertrouwelijke informatie naar een Amerikaanse cloud, of alleen naar een model in de EU of op eigen hardware?
Zonder antwoorden op die vragen bouw je een systeem op aannames, en die komen pas boven tafel als er iets misgaat. Daarom behandel ik in de volgende delen elke laag samen met de keuzes die erbij horen, en niet als los beleidsdocument achteraf.
Eén stroom data houdt geen van deze lagen tegen: wat medewerkers zelf in de chat plakken. Of een klantmail of personeelskwestie daar thuishoort, kan alleen de medewerker op dat moment beoordelen. Dat past dus niet bij een van de lagen, en daarom krijgt het een eigen deel aan het eind van deze serie.
Begin bij de vragen
Dit speelt eerder dan je misschien denkt. Het context platform, het agentic operating system en model orchestration hebben naar verwachting alle drie binnen één tot drie jaar grote impact.
Je hoeft niet morgen alle drie de lagen in te richten. Maar je kunt wel vandaag de vragen beantwoorden die eronder liggen. Welke kennis moet AI hebben? Wat mag het zelfstandig doen? Welk model voor welk werk? En wat verwacht je van de mensen die ermee werken?
Wie die antwoorden heeft, kan per stap tooling kiezen die erbij past. Wie ze niet heeft, koopt dure tools die gouden bergen beloven, maar heeft geen grip op wat AI in het bedrijf doet.
In het volgende deel beginnen we bij de eerste laag: het context platform. Hoe maak je van losse documenten en kennis in hoofden een contextlaag voor het hele bedrijf? En welke data hoort daar wel en niet in?