Grip op je tokenverbruik: niet elke taak verdient je beste model
Het beste model op de hoogste stand voelt veilig, maar je betaalt voor denkwerk dat niemand vroeg. Zo kies je per taak het juiste model en de juiste effort, en ontdek je misschien wel wanneer een lokaal model ook voldoende is.
Consultant van 250 euro per uur opent elke dag de post
Bij een adviesbureau in Zwolle opent de duurste consultant elke dag de ochtendpost. “Ze is nu eenmaal de slimste die we hebben,” legt de directeur uit. “Dan weet je zeker dat het goed gaat.” De consultant denkt bij elke envelop eerst een kwartier na voordat ze hem openmaakt. Het bureau overweegt haar volgende week ook de koffie te laten zetten.
Niemand zou dat zo regelen. Toch is het precies wat je doet als je AI alles laat doen op de hoogste stand. Het beste model, effort op max, en dan voor alles. Een bestand hernoemen, een mail samenvatten, een complete codebase doorzoeken. Allemaal door je duurste kracht, die er ook nog eens extra lang over nadenkt.
Wat het je kost
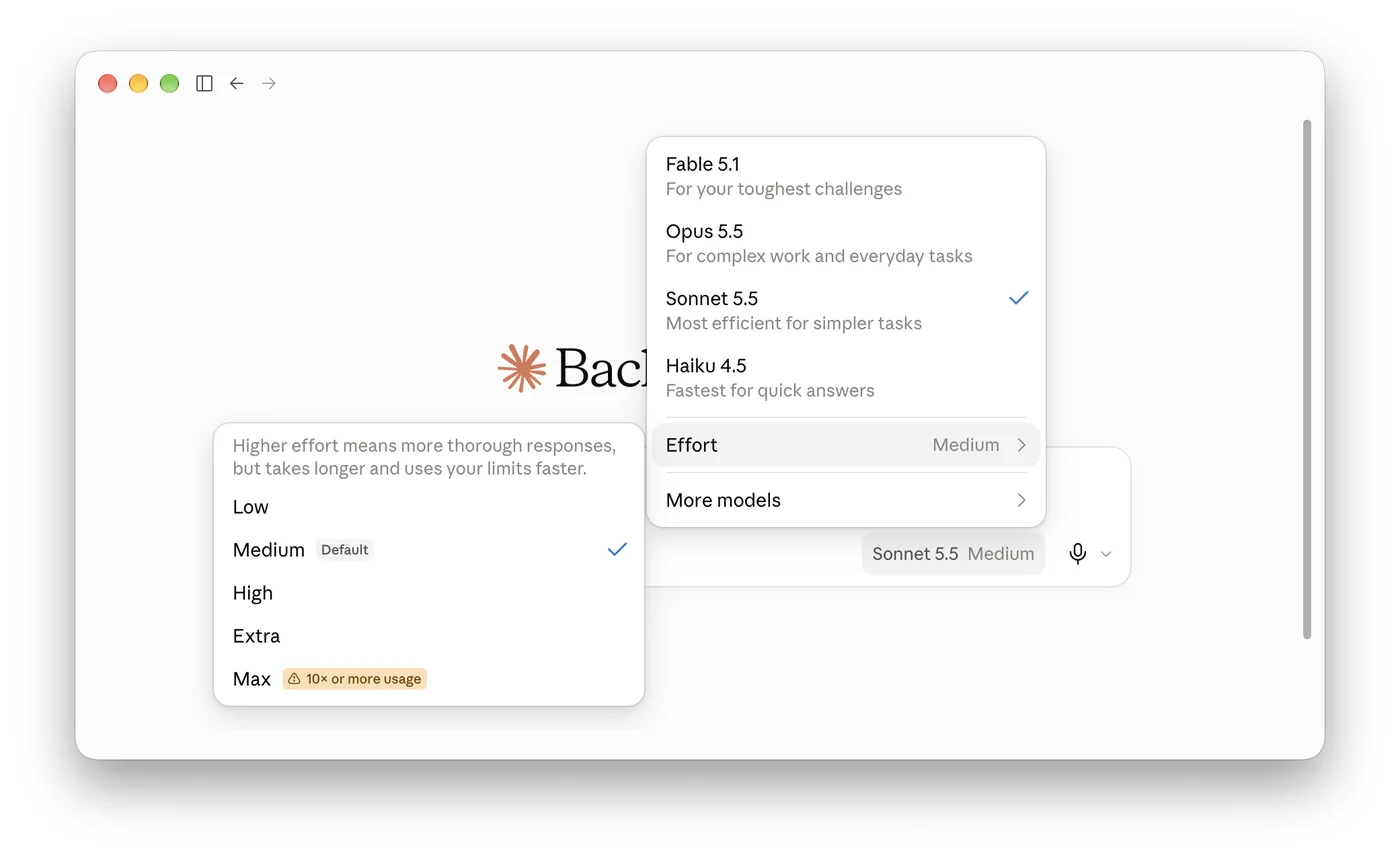
De prijsverschillen zijn groter dan veel mensen denken. Per miljoen tokens kost Opus 5.5 vier keer zoveel als Haiku 4.5. Fable 5.1, het zwaarste model, zelfs tien keer zoveel. De actuele prijzen per model vind je in het prijsoverzicht van Anthropic.
Werk je met een abonnement zoals Pro of Team, dan betaal je niet per token. Maar je limiet raakt sneller op, en dan sta je halverwege de middag stil. Hetzelfde probleem, andere vorm.
En effort telt daar nog bovenop. Effort bepaalt hoe lang het model nadenkt voordat het antwoordt. Hoe hoger, hoe meer tokens het verbruikt aan denken, ook als de vraag dat helemaal niet nodig heeft.
Laat het zware werk delegeren
Het mooiste wapen hiervoor is de subagent. Dat is een aparte helper die een deeltaak oppakt, met een eigen model. Je hoofdgesprek blijft op het slimme model, en het uitzoekwerk gaat naar een goedkopere collega.
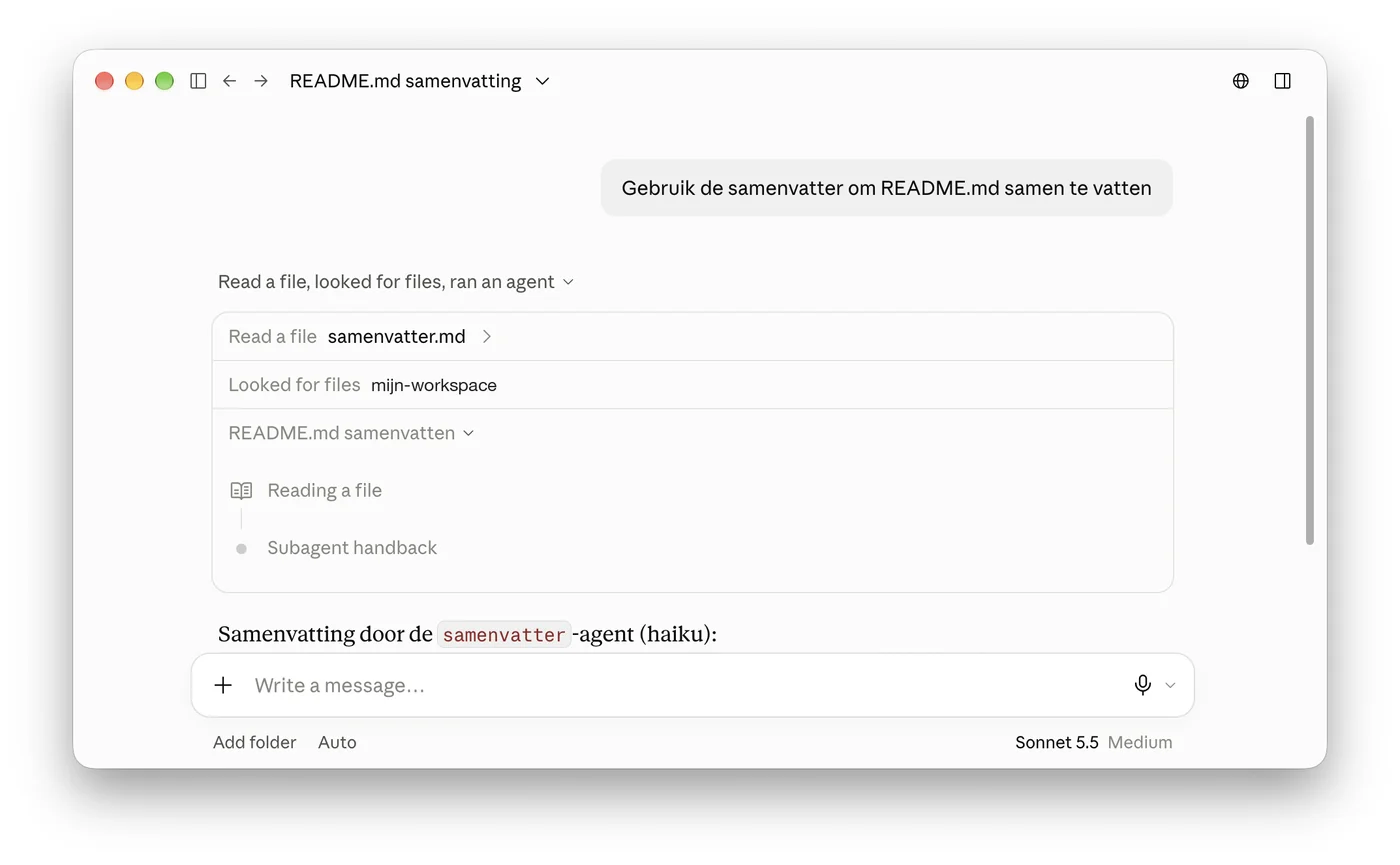
Werk je in Cowork met een eigen werkmap, zoals in deel 1 van de serie over AI beter gebruiken, dan zet je in die map een bestand samenvatter.md in de submap .claude/agents/. Bovenin staat wanneer Claude hem inschakelt en welk model hij gebruikt, daaronder wat hij moet doen. De regel model: haiku bepaalt wat hij kost:
---
name: samenvatter
description: Vat een bron kort samen in het Nederlands, zoals een bestand, document, webpagina of geplakte tekst, en geeft alleen de kern terug. Gebruik deze agent als je een lange bron moet lezen terwijl je alleen de conclusie nodig hebt, of als je meerdere bronnen tegelijk wilt laten samenvatten. Voorbeelden zijn "vat dit document samen", "wat staat er in deze pagina" en "geef me de kern van deze mail".
model: haiku
---

Je bent een samenvatter. Je leest bronnen zodat het hoofdgesprek dat niet hoeft te doen, en je geeft alleen terug wat nodig is.

## Werkwijze

1. Lees de bron die je krijgt volledig.
2. Haal de kern eruit: waar gaat het over, wat is de stand van zaken, wat moet er gebeuren en wie is aan zet.
3. Geef je antwoord in dit formaat:

**Bron:** titel of bestandsnaam
**Kern:** één tot twee zinnen
**Belangrijkste punten:** maximaal vijf korte punten
**Actie nodig:** wat er moet gebeuren, of "geen"

## Regels

- Schrijf in het Nederlands, kort en zakelijk.
- Verzin niets. Staat iets niet in de bron, zeg dat dan.
- Geef geen advies of mening, alleen wat er staat.
Of laat Claude de subagent voor je aanmaken. Plak dit in Cowork, in je werkmap:
Maak in deze werkmap een subagent "samenvatter" in .claude/agents/. Hij vat bronnen kort samen in het Nederlands en geeft alleen de kern terug. Laat hem draaien op het model haiku, en zorg voor een duidelijke beschrijving zodat je zelf weet wanneer je hem inschakelt.Vraag daarna in Cowork om de samenvatter te gebruiken, en Claude geeft het werk door. Het hoofdgesprek draait hier op Sonnet 5.5, de samenvatter op Haiku:
Een model per skill
Hetzelfde kan bij skills, de vaste werkwijzen die je Claude leert. Hoe je die bouwt, liet ik zien in deel 2 van de serie over AI beter gebruiken. Ook in een skill kun je vastleggen welk model hij gebruikt.
Hier zit wel een addertje. Met alleen de regel model: haiku blijft de skill gewoon op het model van je gesprek draaien. Zet je er context: fork bij, dan werkt het wel:
---
name: actiepunten
description: Haalt de actiepunten uit vergadernotities, een transcript of een lange mailwisseling. Gebruik bij "wat zijn de actiepunten", "wie moet wat doen" of als de gebruiker notities plakt van een overleg.
model: haiku
context: fork
---

# Actiepunten

Lees de tekst en haal alle afspraken eruit waar iemand iets mee moet. Geef per actiepunt:

- wat er moet gebeuren
- wie het doet, of "onbekend"
- wanneer het af moet zijn, of "geen deadline genoemd"

Verzin niets. Is iets onduidelijk, zet het dan onder een kopje "Nog uitzoeken".
Met context: fork draait de skill als een losse helper, en dan wordt het model wel gerespecteerd. Let op: die helper ziet je gesprek niet. Zet dus alles wat hij nodig heeft in de skill zelf, of geef het mee in je vraag.
Heb je je skill gemaakt zoals in deel 2? Open hem dan onder Customize > Skills, klik op Edit en zet de regels model: haiku en context: fork direct onder de regel description.
Wanneer is goedkoper prima?
Een goedkoper model is prima zodra de taak duidelijk is en jij het resultaat toch nog ziet. Zoeken en lezen, samenvatten, gegevens uit documenten halen, iets omzetten naar een ander format. Het verschil met het topmodel merk je dan nauwelijks, en je betaalt een fractie. Het beste model is zijn prijs waard als er gepland moet worden over meerdere stappen, als nuance telt in een tekst voor een klant, of als een wijziging in een grote codebase overal effect kan hebben.
Probeer ook eens het beste model op een lagere effort, voordat je naar een kleiner model stapt. Reken daarbij per afgeronde taak, niet per vraag. Een goedkoop model dat drie pogingen nodig heeft, is niet goedkoop.
Medium, high of nog hoger?
Voor effort helpt een simpele vuistregel, grotendeels gebaseerd op de richtlijnen van Anthropic zelf.
Low is voor snel heen-en-weer waarbij je elk antwoord zelf ziet. Brainstormen, een eerste schets, iets hernoemen.
Medium is je standaard, en ook de stand waarop Claude Code zelf begint. Dagelijks werk met een duidelijke opdracht: een feature bouwen, een document opstellen, een analyse waarvan je weet wat je zoekt.
High zet je aan als controle ertoe doet. Een bug in bestaande code, een offerte met cijfers die moeten kloppen, alles waar randgevallen waarschijnlijk zijn.
En de hoogste standen bewaar je voor de klussen die Claude zelfstandig moet doorworstelen zonder dat jij meekijkt. Een beveiligingscheck, een lastig probleem waar je zelf ook niet uitkomt.
Twijfel je of je de effort hoger moet zetten of een slimmer model moet kiezen? Kijk dan waarom het misging. Sloeg Claude een stap over of controleerde hij zijn werk niet, zet dan de effort hoger. Had hij alles wat hij nodig had en zat hij er toch naast, kies dan een slimmer model.
En als het niet de cloud in hoeft?
Met tools als Ollama en LM Studio zet je open-source modellen op je eigen computer. Wat er lokaal draait en hoe goed die modellen inmiddels zijn, schreef ik eerder in open-source AI in 2026.
Laatst draaide ik met een engine die Colibrì heet een model van 744 miljard parameters op een server zonder videokaart. Het werkte, de antwoorden klopten zelfs. Alleen schreef het nog geen twee woorden per seconde. Voor een agent die met je meedenkt was dat onbruikbaar: die stuurt bij elke beurt zijn hele context opnieuw mee, en alleen dat inlezen duurde al langer dan een uur.
Met een kleiner model ligt dat heel anders. Neem Qwen 3.5 in de kleine versie van 4 miljard parameters. Dat is een download van zo’n 3,5 GB, en hij draait met LM Studio of Ollama gewoon op een laptop met 8 GB geheugen. Een tekst samenvatten, een mail herschrijven, gegevens uit een document halen: daar heb je geen topmodel voor nodig. De tools en de modellen zijn gratis, je betaalt niets per vraag, en je gegevens verlaten je computer niet.
Wat ik je mee wil geven
Het beste model op de hoogste stand voelt als de veilige keuze. Maar je betaalt voor denkwerk dat niemand gevraagd heeft, en je loopt eerder tegen je limiet aan.
Kijk eens naar wat je deze week met AI hebt gedaan. Hoeveel daarvan had echt je beste model nodig? En hoeveel had een slimme helper op de achtergrond kunnen doen?